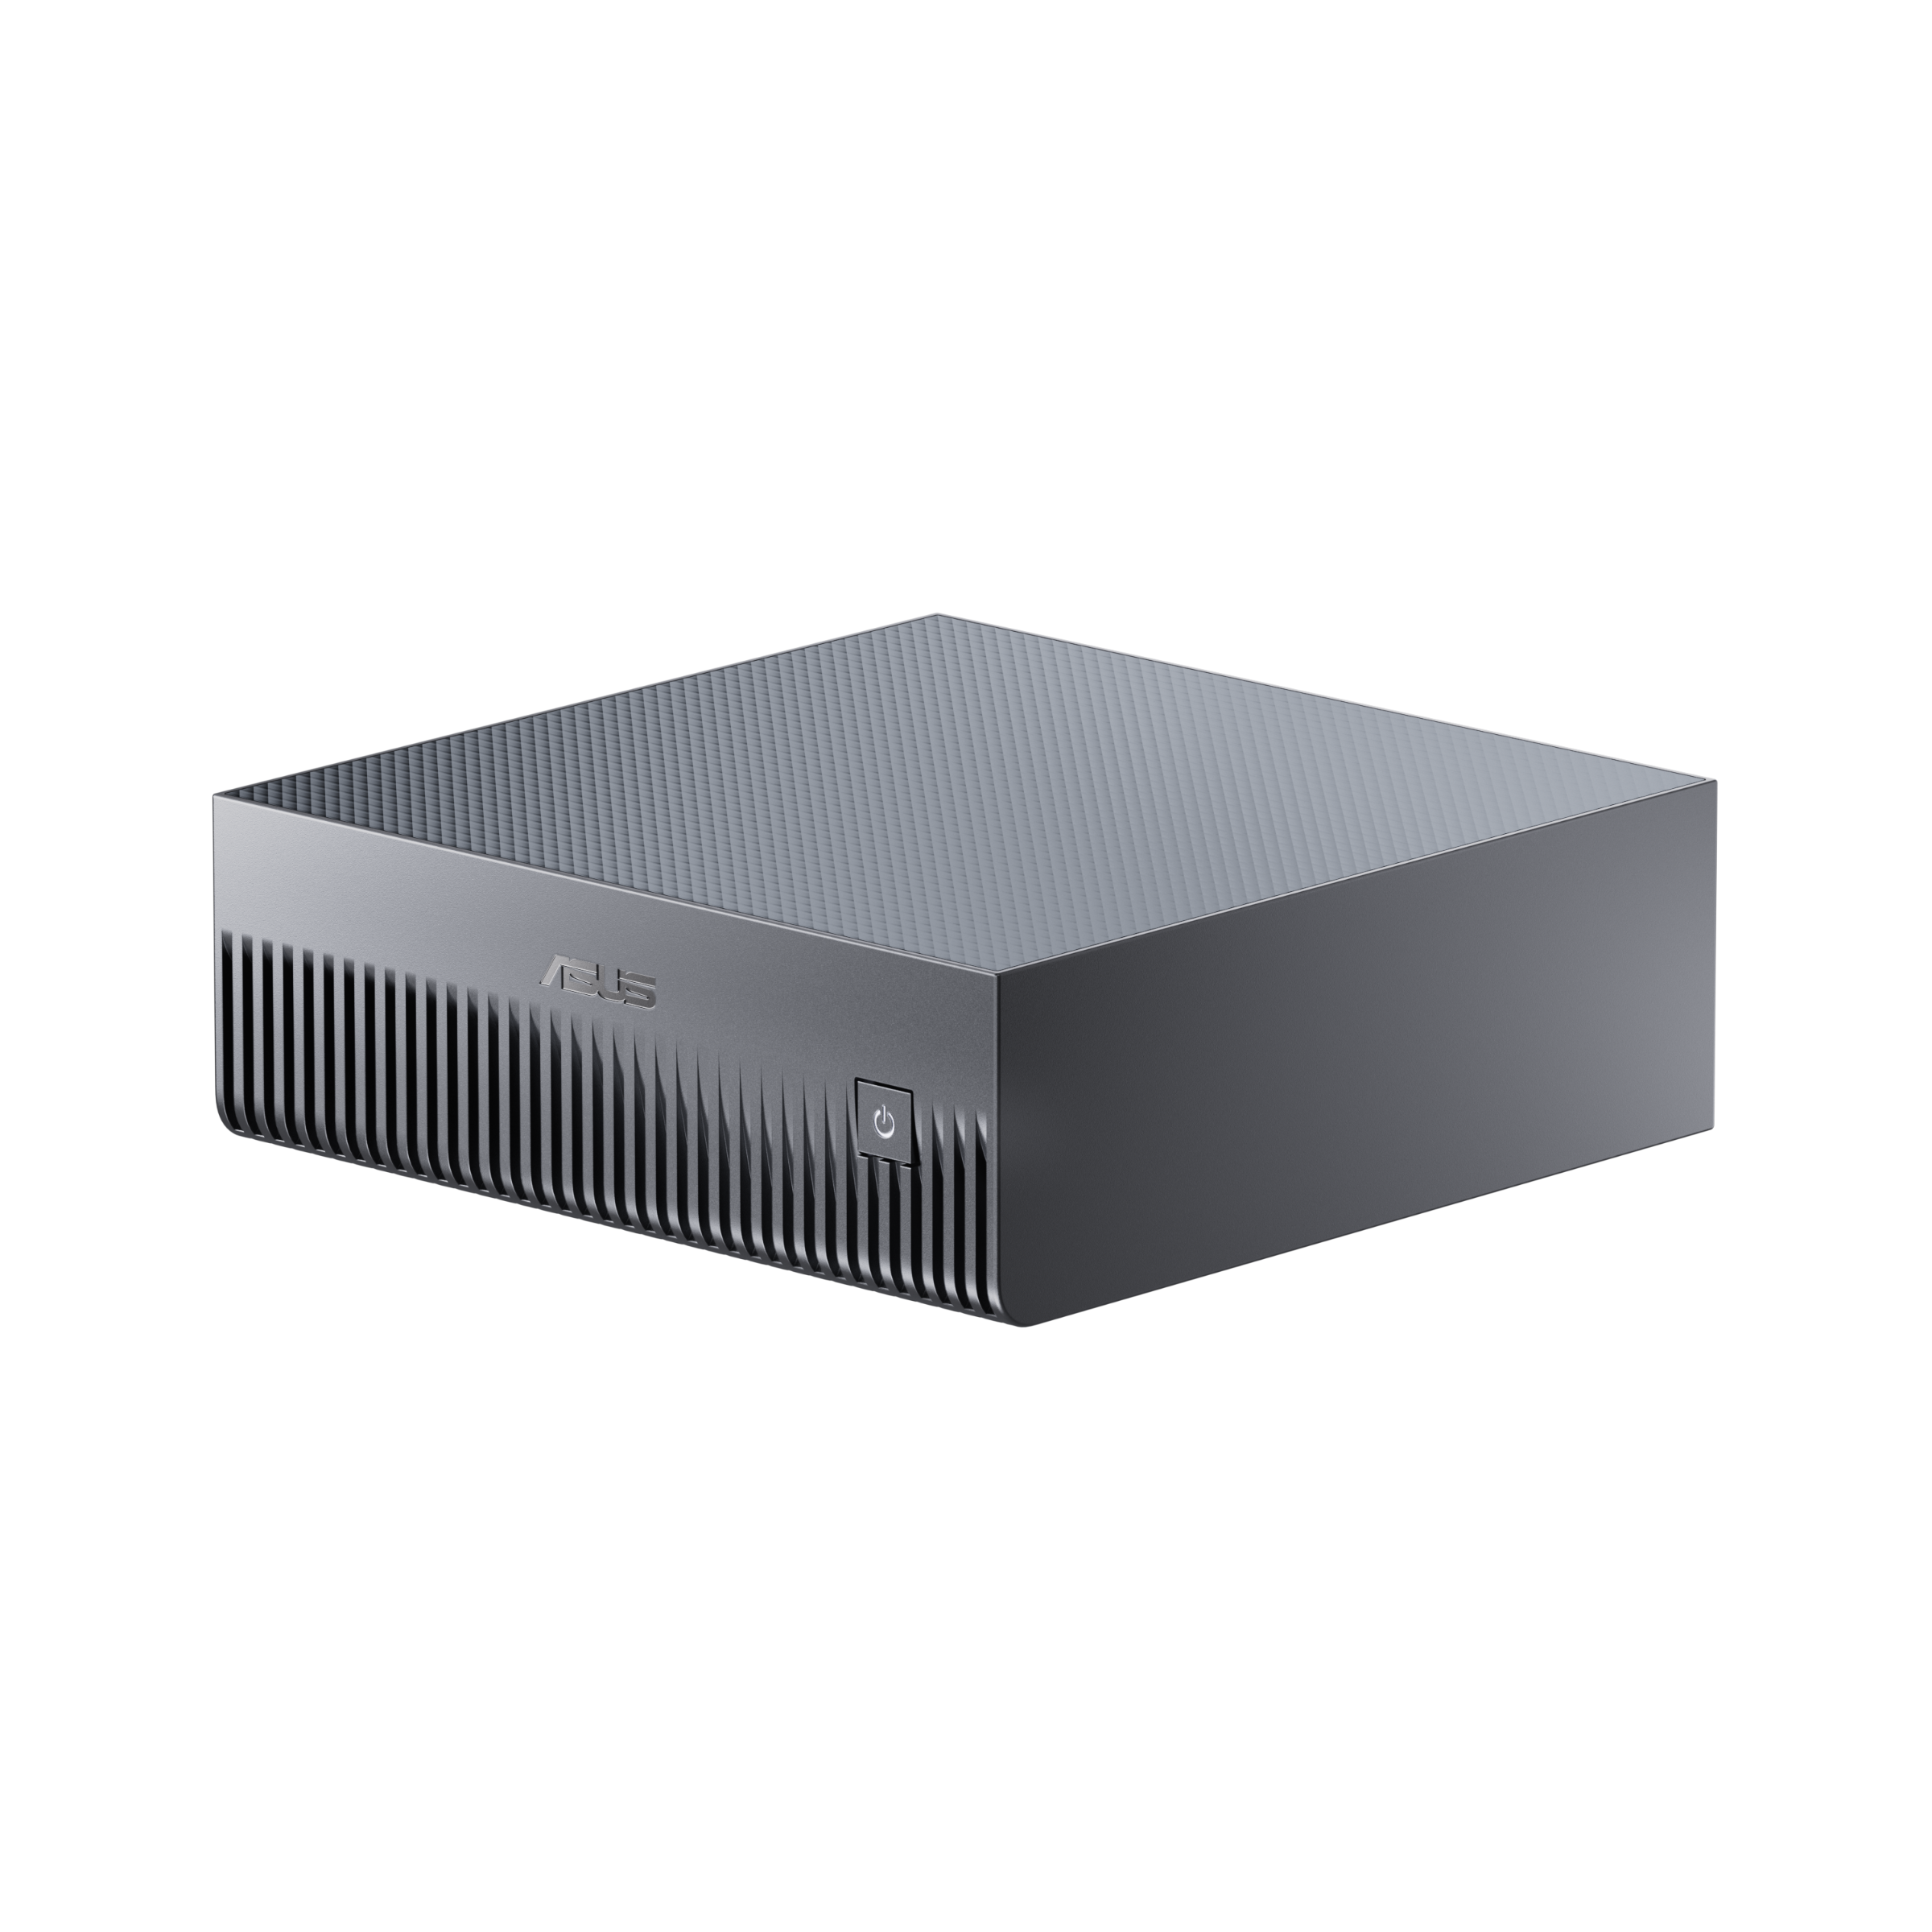
Два ASUS GX10, по 128 GB единой памяти на каждом. Запускайте независимые модели одновременно или распределяйте большую задачу между узлами с поддержкой вашего runtime.
Кластер из двух ASUS GX10
Запускайте две задачи параллельно или распределяйте одну модель между узлами.
Кластер состоит из двух отдельных систем ASUS Ascent GX10. У каждой — NVIDIA GB10 и 128 ГБ памяти, общей для CPU и GPU. На узлах можно параллельно запускать разные задачи. Чтобы распределить одну модель между двумя системами, используемое ПО должно поддерживать multi-node и соединение ConnectX-7.
Память двух устройств не объединяется в один непрерывный пул: на каждом узле системе, контексту и буферам нужна собственная память. Кластер работает на платформе NVIDIA GB10 Grace Blackwell и требует совместимого ARM64-окружения. В заявке укажите, нужны ли вам независимые задачи или распределённый запуск, а также срок аренды.
Отдайте каждой модели отдельный GX10 с собственными 128 GB общей памяти. Сравнивайте качество и настройки параллельно, без очереди на один узел.
02
Распределённый запуск на двух узлах
Распределяйте веса и вычисления между двумя GB10 через ConnectX-7, если это поддерживает ваш движок. На каждом узле память отдельно используют система, контекст и буферы.
03
Инференс и эксперименты параллельно
Оставьте один узел для текущей модели, а второй используйте для дообучения, оценки новой версии или обработки данных. Задачи получают отдельные вычислительные ресурсы.
ОЦЕНКА ПАМЯТИ
Как рассчитать память для LLM
Сначала рассчитайте объём весов. Затем добавьте KV-кеш, память runtime, операционной системы и рабочих буферов.
Оценка объёма только весов, ГБ
Параметры
4 бит
8 бит
16 бит
8B
4
8
16
14B
7
14
28
32B
16
32
64
70B
35
70
140
120B
60
120
240
Расчёт: число параметров × битность / 8. Без служебных данных формата квантования, контекста и runtime.
70B при 4 битах: около 35 ГБ весов
На карте с 24 ГБ такая модель не помещается целиком в VRAM даже без контекста. У GX10 есть больший общий бюджет памяти — 128 ГБ для CPU и GPU. Итоговую нагрузку определяют ещё длина контекста и число запросов.
Для крупных моделей
Кластер из двух ASUS GX10 подходит для моделей с крупными весами и параллельных задач.
Укажите модель, программное окружение и срок аренды. До начала подтвердим цену, доступность и способ подключения.
1 092,00 ₽от231,40 ₽/ часставка «от» при аренде от 169 часов
Предложение действует ещё—дн.—ч—мин—сек
FAQ
Частые вопросы об аренде ASUS GX10
Как считается стоимость аренды двух GX10?
Тариф на этой странице относится к конфигурации из двух узлов. Сопоставляйте его с длительностью работы и загрузкой обоих GX10. Итоговая стоимость, срок и состав ресурсов согласуются по заявке; заявка не резервирует оборудование автоматически.
2 × 128 ГБ — это одна видеокарта на 256 ГБ?
Нет. Это две системы со своей памятью. На каждой CPU, GPU и ОС делят 128 ГБ LPDDR5x. Общая модель должна распределяться между узлами средствами приложения; соединение само по себе не создаёт единый непрерывный пул. Независимые задания используют память каждого узла отдельно.
Нужны ли два GX10 для модели 70B?
Не обязательно: квантованная модель 70B может поместиться на одном узле, если достаточно места для контекста и runtime. Паре можно поручить независимые запуски или поддерживаемую распределённую конфигурацию. В FP16/BF16 одни веса 70B занимают примерно 140 ГБ; для распределения также потребуются память на каждом узле и подходящий движок.
Работают ли Ollama, PyTorch и Docker на двух узлах?
На каждом GX10 нужны ARM64-совместимые сборки и поддержка Blackwell в выбранных CUDA-библиотеках. Два Docker-контейнера не распределяют модель автоматически. Независимые экземпляры Ollama или приложения PyTorch могут работать на разных узлах; для одной общей задачи нужны явная поддержка multi-node и настроенный обмен.
Сколько токенов в секунду даёт пара GX10?
Собственных измерений TPS для этой пары мы пока не публиковали. Результат одной модели зависит от квантования, контекста, движка и сетевого обмена. Два узла не гарантируют удвоение TPS. Для независимых задач полезнее сравнивать общий объём выполненной работы за время аренды.
Когда выбирать пару вместо одного GX10?
Пара полезна для двух одновременных экспериментов, отдельного узла под инференс или задачи, которую движок умеет разделить между системами. Если один GX10 вмещает модель и даёт подходящее время ответа, второй не обязателен. Доступность одиночного узла и пары связана: это один парк из двух устройств.
Это кластер NVIDIA DGX Spark или ASUS?
В этой конфигурации два устройства ASUS Ascent GX10. Они используют NVIDIA GB10 Grace Blackwell и платформу, общую с DGX Spark, но производитель и модель систем — ASUS. Название NVIDIA DGX OS относится к программной платформе. Условия доступа и соединения определяются нашей конфигурацией, а не названием семейства NVIDIA.
Что указать в заявке на два узла?
Пришлите модель, формат весов, версии движка и контейнера, команду запуска, контекст и ожидаемую нагрузку. Укажите, будут ли задания независимыми или нужен распределённый запуск, а также требования к обмену и данным. Добавьте даты и длительность. Пароли, приватные SSH-ключи и API-токены в заявку не нужны.