27B
Универсальная мультимодальная модель
Qwen3.6 27B
Общение, анализ документов и изображений, программирование и задачи с длинным контекстом.
КвантованиеGGUF Q4_K_M или Q5_K_Mпримерно 17–22 ГБ весов
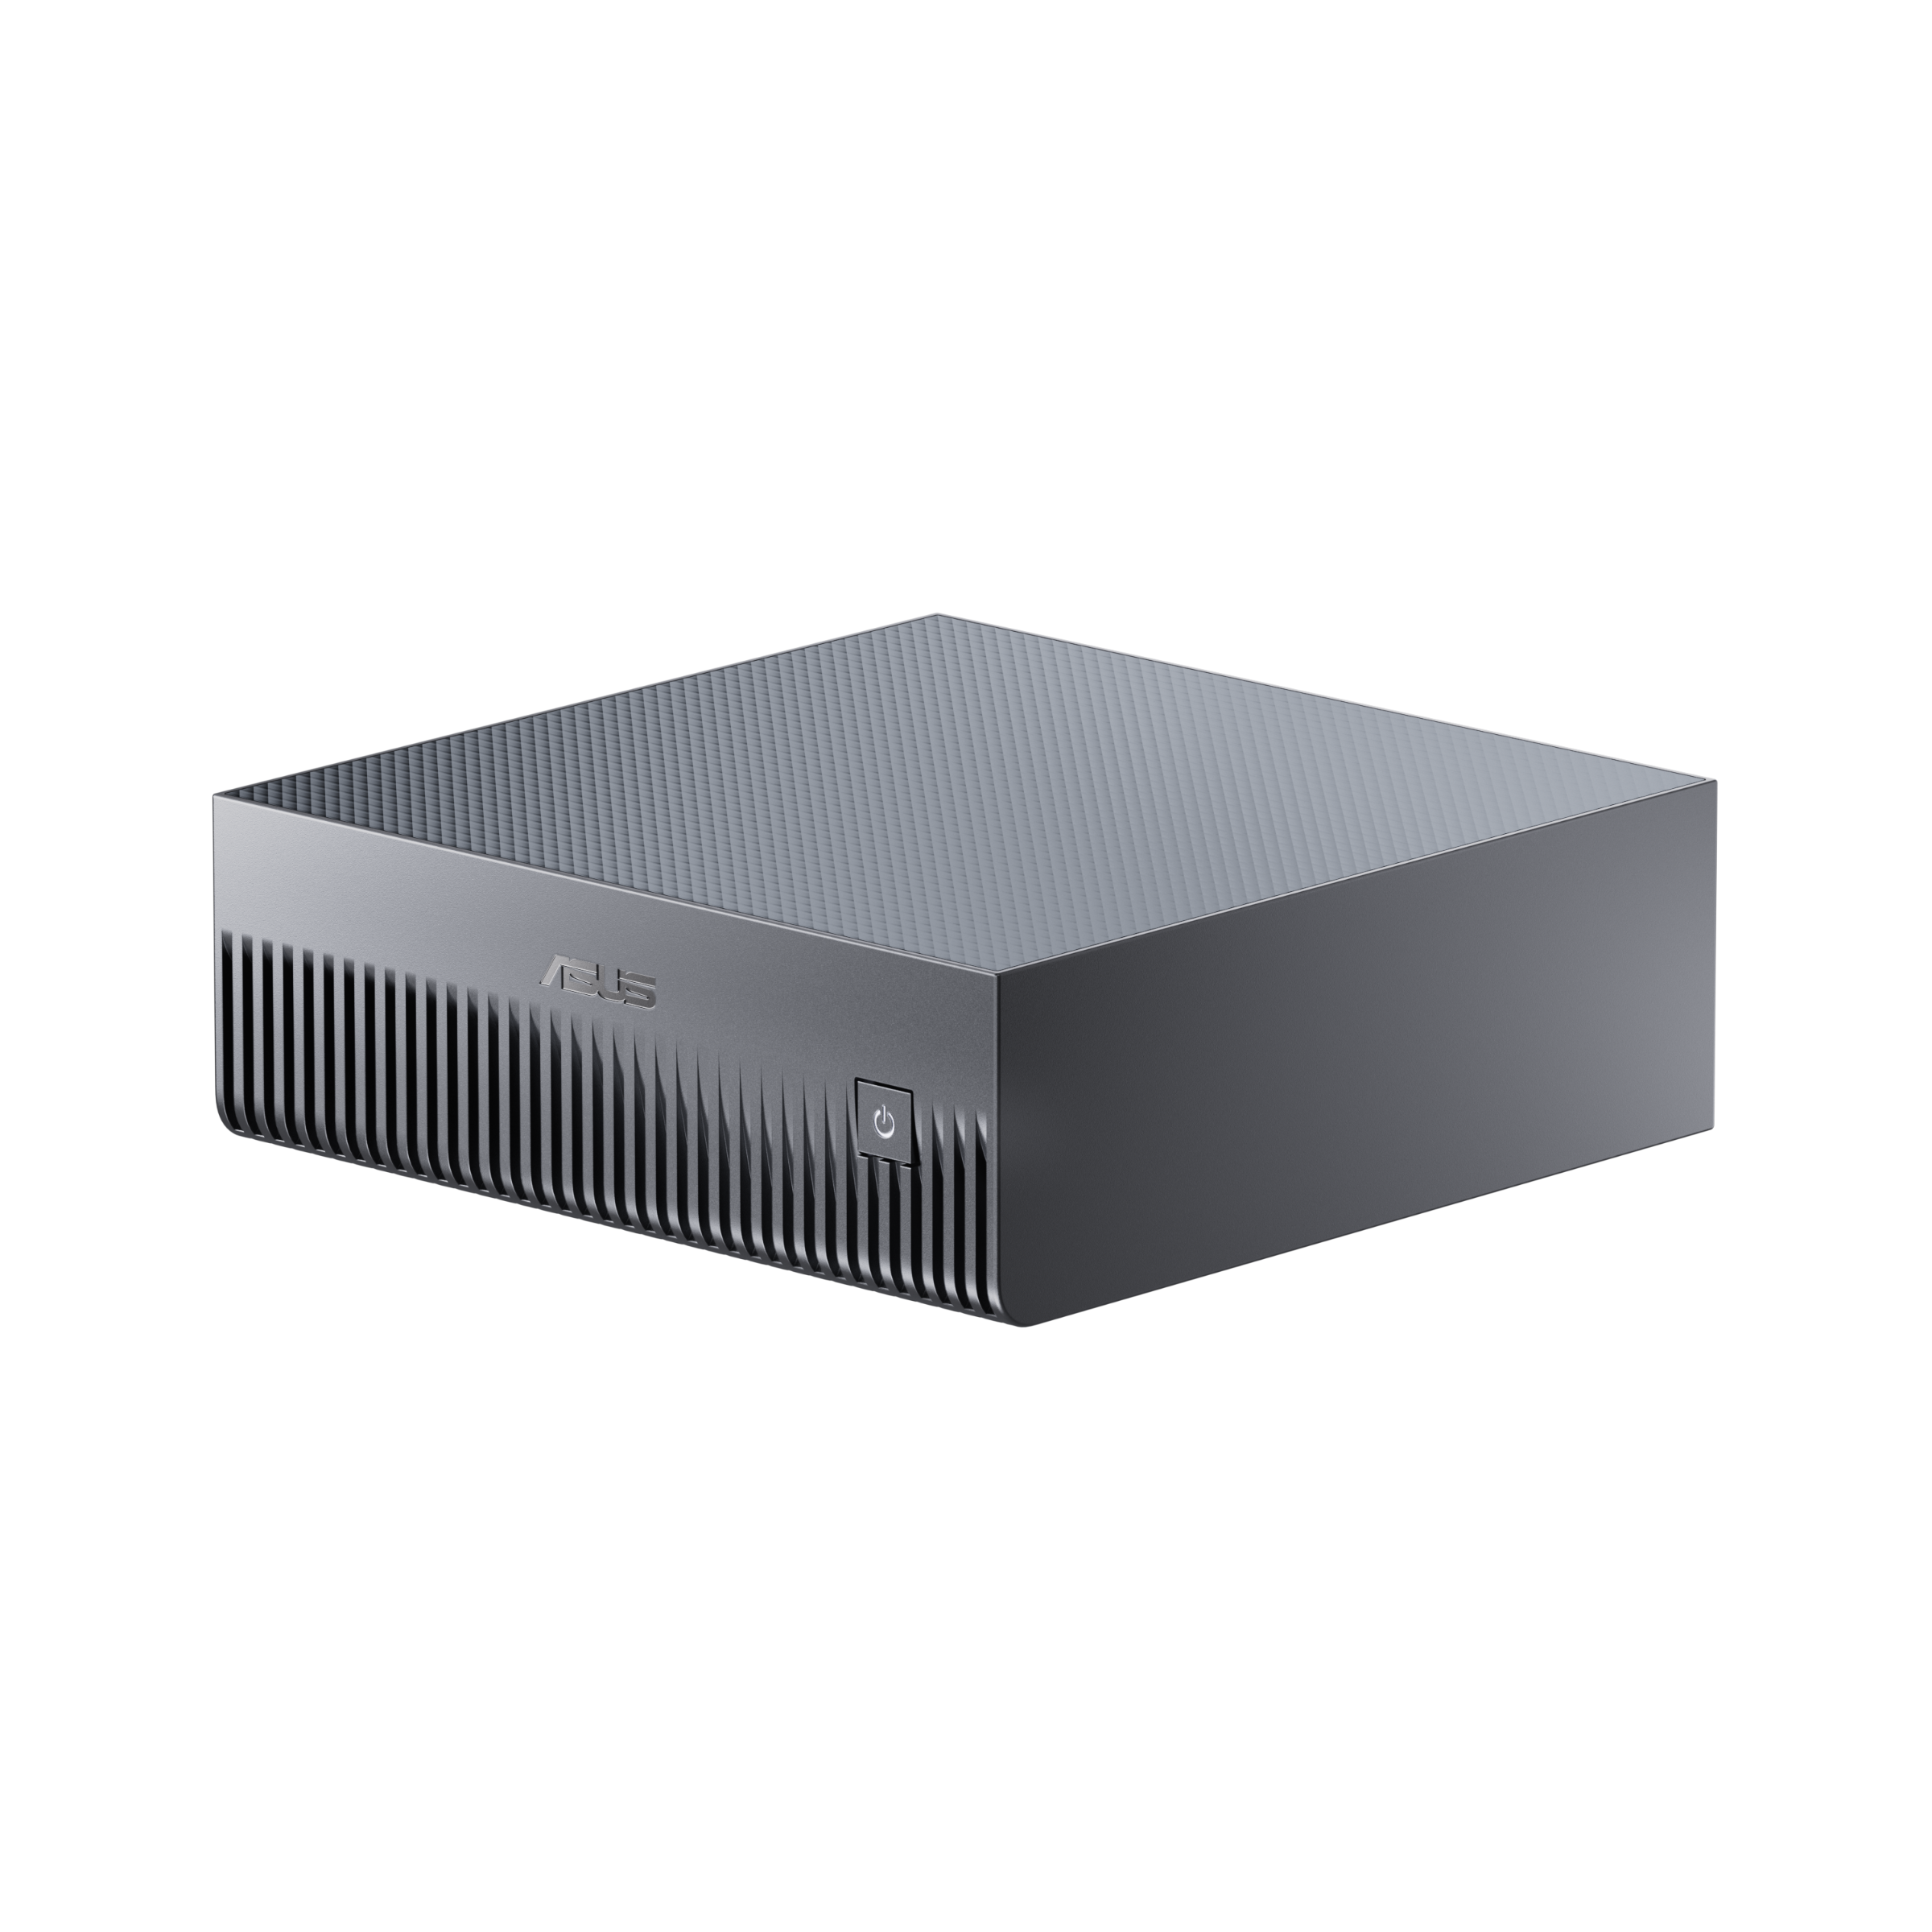
КонфигурацияОдин узел ASUS GX10
ASUS GX10 имеет 128 GB памяти, общей для CPU и GPU. Учитывайте этот объём для весов LLM, контекста, системы и рабочих данных.
ASUS GX10 с 128 ГБ общей памяти
128 ГБ единой памяти для весов, контекста и экспериментов с LLM.
В каталоге указаны задачи, варианты квантования и размер весов. Шесть моделей уже предустановлены в ASUS GX10.
Универсальная мультимодальная модель
Общение, анализ документов и изображений, программирование и задачи с длинным контекстом.
Быстрая MoE-модель для кода и анализа
Подходит для кодовых задач, диалога и анализа изображений. MoE активирует часть параметров на каждом токене.
Код, репозитории и агенты
Специализированная модель для работы с кодовой базой, отладки, генерации кода и инструментальных сценариев.
Крупная открытая модель для сложных запросов
Модель OpenAI с MoE-архитектурой и встроенным форматом MXFP4. Подходит для рассуждений, кода и локального ассистента.
Анализ изображений и видео
Отвечает по скриншотам, фотографиям, видео и документам с визуальным содержимым.
Чат и работа с текстом
Предустановлена на ASUS GX10. Отвечает на русском и английском, помогает с текстами, переводом и документами.
Разработка и кодовые агенты
Предустановлена на ASUS GX10. Пишет и объясняет код, помогает отлаживать приложения и работать с инструментами.
Рассуждения, математика и логика
Предустановленная дистилляция DeepSeek-R1 на базе Qwen 32B для многошаговых задач и аналитики.
Изображения и документы
Предустановлена на ASUS GX10. Понимает текст и изображения, анализирует скриншоты, схемы и страницы документов.
Диалоги и большие документы
Предустановлена на ASUS GX10. Используйте для подробных ответов, суммаризации и диалоговых приложений.
Uncensored-модель для диалога и творчества
Предустановленная модель с uncensored-настройкой на базе Llama 3.1. Подходит для свободного диалога и творческих текстов.
Генерация и редактирование изображений
Открытые веса Black Forest Labs для генерации изображений по описанию и редактирования исходной картинки.
Генерация изображений и текста в кадре
Модель Qwen для генерации и правки изображений, включая композиции со встроенными надписями.
Видео по тексту или изображению
Одна модель поддерживает генерацию видео по текстовому запросу и анимацию исходного изображения.
Генерация видео по тексту
Более крупная MoE-модель Wan для создания видео по тексту. Для выбранного разрешения проверим полный pipeline и скорость.
Новости и финансовые тексты
Модель для классификации финансовой тональности и анализа новостей и отчётов. Не выдаёт готовую торговую стратегию.
Прогноз временных рядов
Специализированная модель для прогнозирования временных рядов. Подойдёт для экспериментов с историческими рыночными данными и бэктестами.
Синтез речи и голосовой дизайн
Создаёт речь по тексту и поддерживает управление голосом. Для русского языка заранее проверим выбранный voice и режим.
MoE-модель для диалога и кода
Крупная модель Mistral для текста и кода. Можно запустить на одном узле в сжатом формате или разделить между двумя.
В одном ASUS Ascent GX10 CPU, GPU и система используют общую память LPDDR5x объёмом 128 ГБ. При оценке модели учитывайте её веса, KV-кеш, контекст и рабочие данные. Конфигурация подходит для инференса квантованных LLM, RAG, AI-агентов и тестов дообучения, если все компоненты помещаются в доступную память.
ASUS Ascent GX10 построен на NVIDIA GB10 Grace Blackwell и использует процессор ARM64. Контейнеры, библиотеки и CUDA-расширения должны поддерживать эту архитектуру. Перед арендой укажите модель, формат квантования, длину контекста и версии ПО: мы проверим конфигурацию и подтвердим цену, доступность и срок.
Сравнить с NVIDIA DGX SparkДля выбранной длительности действует одна ставка за час. Калькулятор умножает её на весь срок аренды.
Цена указана за один ASUS Ascent GX10 с 128 ГБ памяти, общей для CPU и GPU.
В таблице указаны цена за час и объём памяти для каждой конфигурации.
У GX10 память общая для CPU и GPU. RTX и A100 используют отдельную видеопамять.
Ставка «от» действует при аренде от 169 часов.
CPU, GPU, система и приложения используют общую LPDDR5x. Часть памяти занимает операционная система и runtime.
Запускайте независимые задачи одновременно или распределяйте одну модель, если выбранное ПО поддерживает multi-node.
| Конфигурация | Память | За час |
|---|---|---|
| ASUS Ascent GX10NVIDIA GB10 · Blackwell | 128 ГБCPU + GPU | Предложение действует ещё—дн.—ч—мин—сек |
| 2 × ASUS Ascent GX10NVIDIA GB10 · Blackwell | 2 × 128 ГБобщая на узел | Предложение действует ещё—дн.—ч—мин—сек |
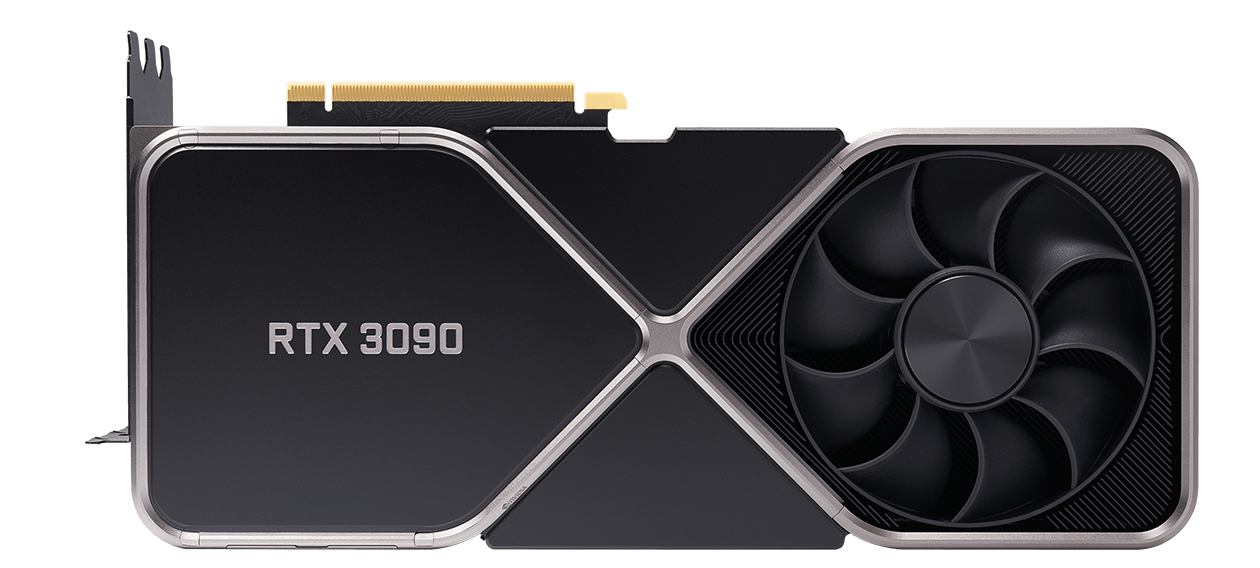
| RTX 3090 | 24 ГБVRAM | 66,28 ₽/ час |
| RTX 4090 | 24 ГБVRAM | 117,97 ₽/ час |
| RTX 5090 | 32 ГБVRAM | 157,74 ₽/ час |
| A100 SXM 80 GB | 80 ГБVRAM | 237,28 ₽/ час |
| H100 SXM 80 GB | 80 ГБVRAM | 528,91 ₽/ час |
Запустите модель и рабочие данные на одном ASUS GX10, если они помещаются в доступную память. Сравнивайте размеры моделей и форматы квантования без настройки кластера.
Используйте бюджет памяти для KV-кеша, документов в контексте и рабочих данных приложения. Подбирайте длину диалога и число параллельных запросов под свой сервис.
Проверьте LoRA или QLoRA на своём датасете. Память для весов, активаций и буферов зависит от метода, модели и размера batch.
Сначала рассчитайте объём весов. Затем добавьте KV-кеш, память runtime, операционной системы и рабочих буферов.
| Параметры | 4 бит | 8 бит | 16 бит |
|---|---|---|---|
| 8B | 4 | 8 | 16 |
| 14B | 7 | 14 | 28 |
| 32B | 16 | 32 | 64 |
| 70B | 35 | 70 | 140 |
| 120B | 60 | 120 | 240 |
Расчёт: число параметров × битность / 8. Без служебных данных формата квантования, контекста и runtime.
На карте с 24 ГБ такая модель не помещается целиком в VRAM даже без контекста. У GX10 есть больший общий бюджет памяти — 128 ГБ для CPU и GPU. Итоговую нагрузку определяют ещё длина контекста и число запросов.
Если модели нужно больше 128 ГБ памяти или вы хотите вести несколько задач параллельно, выберите кластер из двух ASUS GX10.
Все модели для ASUS GX10В каждом узле — 128 ГБ памяти, общей для CPU и GPU. Система построена на NVIDIA GB10 Grace Blackwell.
Технические данные ASUSУкажите модель, формат весов, движок, длину контекста и желаемые даты. Для дообучения добавьте метод и размер датасета.
Обсудим совместимость ARM64, доступ, хранилище, итоговую стоимость и доступность. Заявка становится арендой после согласования условий.
Подключитесь согласованным способом и запустите небольшой пример. Замерьте память и скорость на своём контексте, затем переходите к основной задаче.
Укажите модель, программное окружение и срок аренды. До начала подтвердим цену, доступность и способ подключения.
Текущий тариф указан на этой странице. Для бюджета учитывайте длительность запуска, а не только цену часа: большой объём памяти помогает вместить задачу, но не определяет её скорость. Итоговую стоимость, срок аренды и состав ресурсов согласуем по заявке.
Это общая системная память LPDDR5x, доступная CPU и GPU, а не отдельная память видеокарты. Часть объёма занимают ОС, runtime и буферы. Для модели нужно одновременно учесть веса и KV-кеш. Такой бюджет нельзя напрямую приравнивать по скорости к GDDR или HBM дискретных GPU.
Квантованная модель 70B может поместиться, но результат зависит от формата, контекста и движка. В FP16/BF16 только веса занимают примерно 140 ГБ, поэтому рассчитывать на полностью размещённую в 128 ГБ неквантованную 70B нельзя. При 4 битах базовая оценка весов — около 35 ГБ, плюс метаданные, KV-кеш и runtime. Пришлите конкретную модель для оценки.
Для GX10 существуют рабочие сценарии с этими инструментами, но совместимость зависит от версии и сборки. Docker-образ должен поддерживать linux/arm64; PyTorch, CUDA-библиотеки и движок инференса — NVIDIA GB10/Blackwell. Готовый x86-64-образ может потребовать пересборки. Укажите точные версии и собственные CUDA-расширения до согласования окружения.
Собственных измерений TPS для предлагаемого GX10 мы пока не публиковали. Скорость зависит от модели, квантования, длины входа, контекста, движка и параллельных запросов. Для сравнения полезно отдельно измерять время до первого токена и скорость последующей генерации на одинаковой задаче.
Начните с одного узла, если модель, контекст и рабочие данные помещаются и скорость устраивает. Второй нужен для параллельных заданий или поддерживаемого распределённого запуска. Он не устраняет автоматически ограничения памяти одного процесса. Обе конфигурации используют один парк из двух устройств, поэтому их доступность связана.
Предлагаемый узел — ASUS Ascent GX10, а не устройство NVIDIA DGX Spark. В основе обеих систем NVIDIA GB10 Grace Blackwell и близкая программная платформа; корпус, охлаждение и варианты комплектации определяет производитель. DGX OS — название операционной системы NVIDIA и не меняет производителя самого GX10.
Укажите ссылку на модель, формат квантования, версии движка и контейнера, длину контекста и параллельность. Для дообучения добавьте метод, batch size и размер датасета. Понадобятся желаемые даты, длительность и требования к доступу и хранению. Для первой проверки подготовьте небольшой пример; секреты и приватные ключи в заявку не включайте.
Как учесть общую память, длину контекста и совместимость ARM64.
ВЫБОР КОНФИГУРАЦИИКогда достаточно одного узла, а когда нужны параллельные или распределённые вычисления.
ДОКУМЕНТАЦИЯПамять, архитектура и совместимость окружения — три вещи, с которых стоит начать.