Запуск LLM для анализа кода
Используйте совместимые открытые модели для разбора исследовательского кода и формулировки гипотез. Проверяйте их на исторических данных.
Арендуйте два ASUS GX10 для запуска совместимых LLM, анализа кода и параллельных исследовательских задач. Тестируйте стратегии на исторических данных с учётом комиссий и проскальзывания; результаты проверяйте через бэктест и paper trading.
256 ГБ · 128 ГБ на узел
128 ГБ единой памяти
79% ниже расчётной ставки DGX Spark при аренде от 169 часовИспользуйте совместимые открытые модели для разбора исследовательского кода и формулировки гипотез. Проверяйте их на исторических данных.
Разделите независимые наборы данных и бэктесты между двумя узлами. Один распределённый запуск требует поддержки со стороны программного обеспечения.
Сначала проверьте гипотезу на данных вне выборки и в paper trading. Вычислительная мощность не гарантирует точность прогноза или прибыль.
Вы запускаете собственные модели и код. До аренды согласуем конфигурацию, цену, доступность и подключение.
Укажите модели, исторические наборы данных, число параллельных тестов и требования к памяти.
Укажите даты и срок аренды. До начала подтвердим цену, доступность и способ подключения.
Подключитесь к узлам и запустите свой код. Добавьте комиссии, проскальзывание и проверку на данных вне обучения.
Два узла по 128 ГБ позволяют одновременно запускать разные модели, наборы данных и backtest. Для одной распределённой задачи ПО должно поддерживать работу между узлами.
Характеристики кластера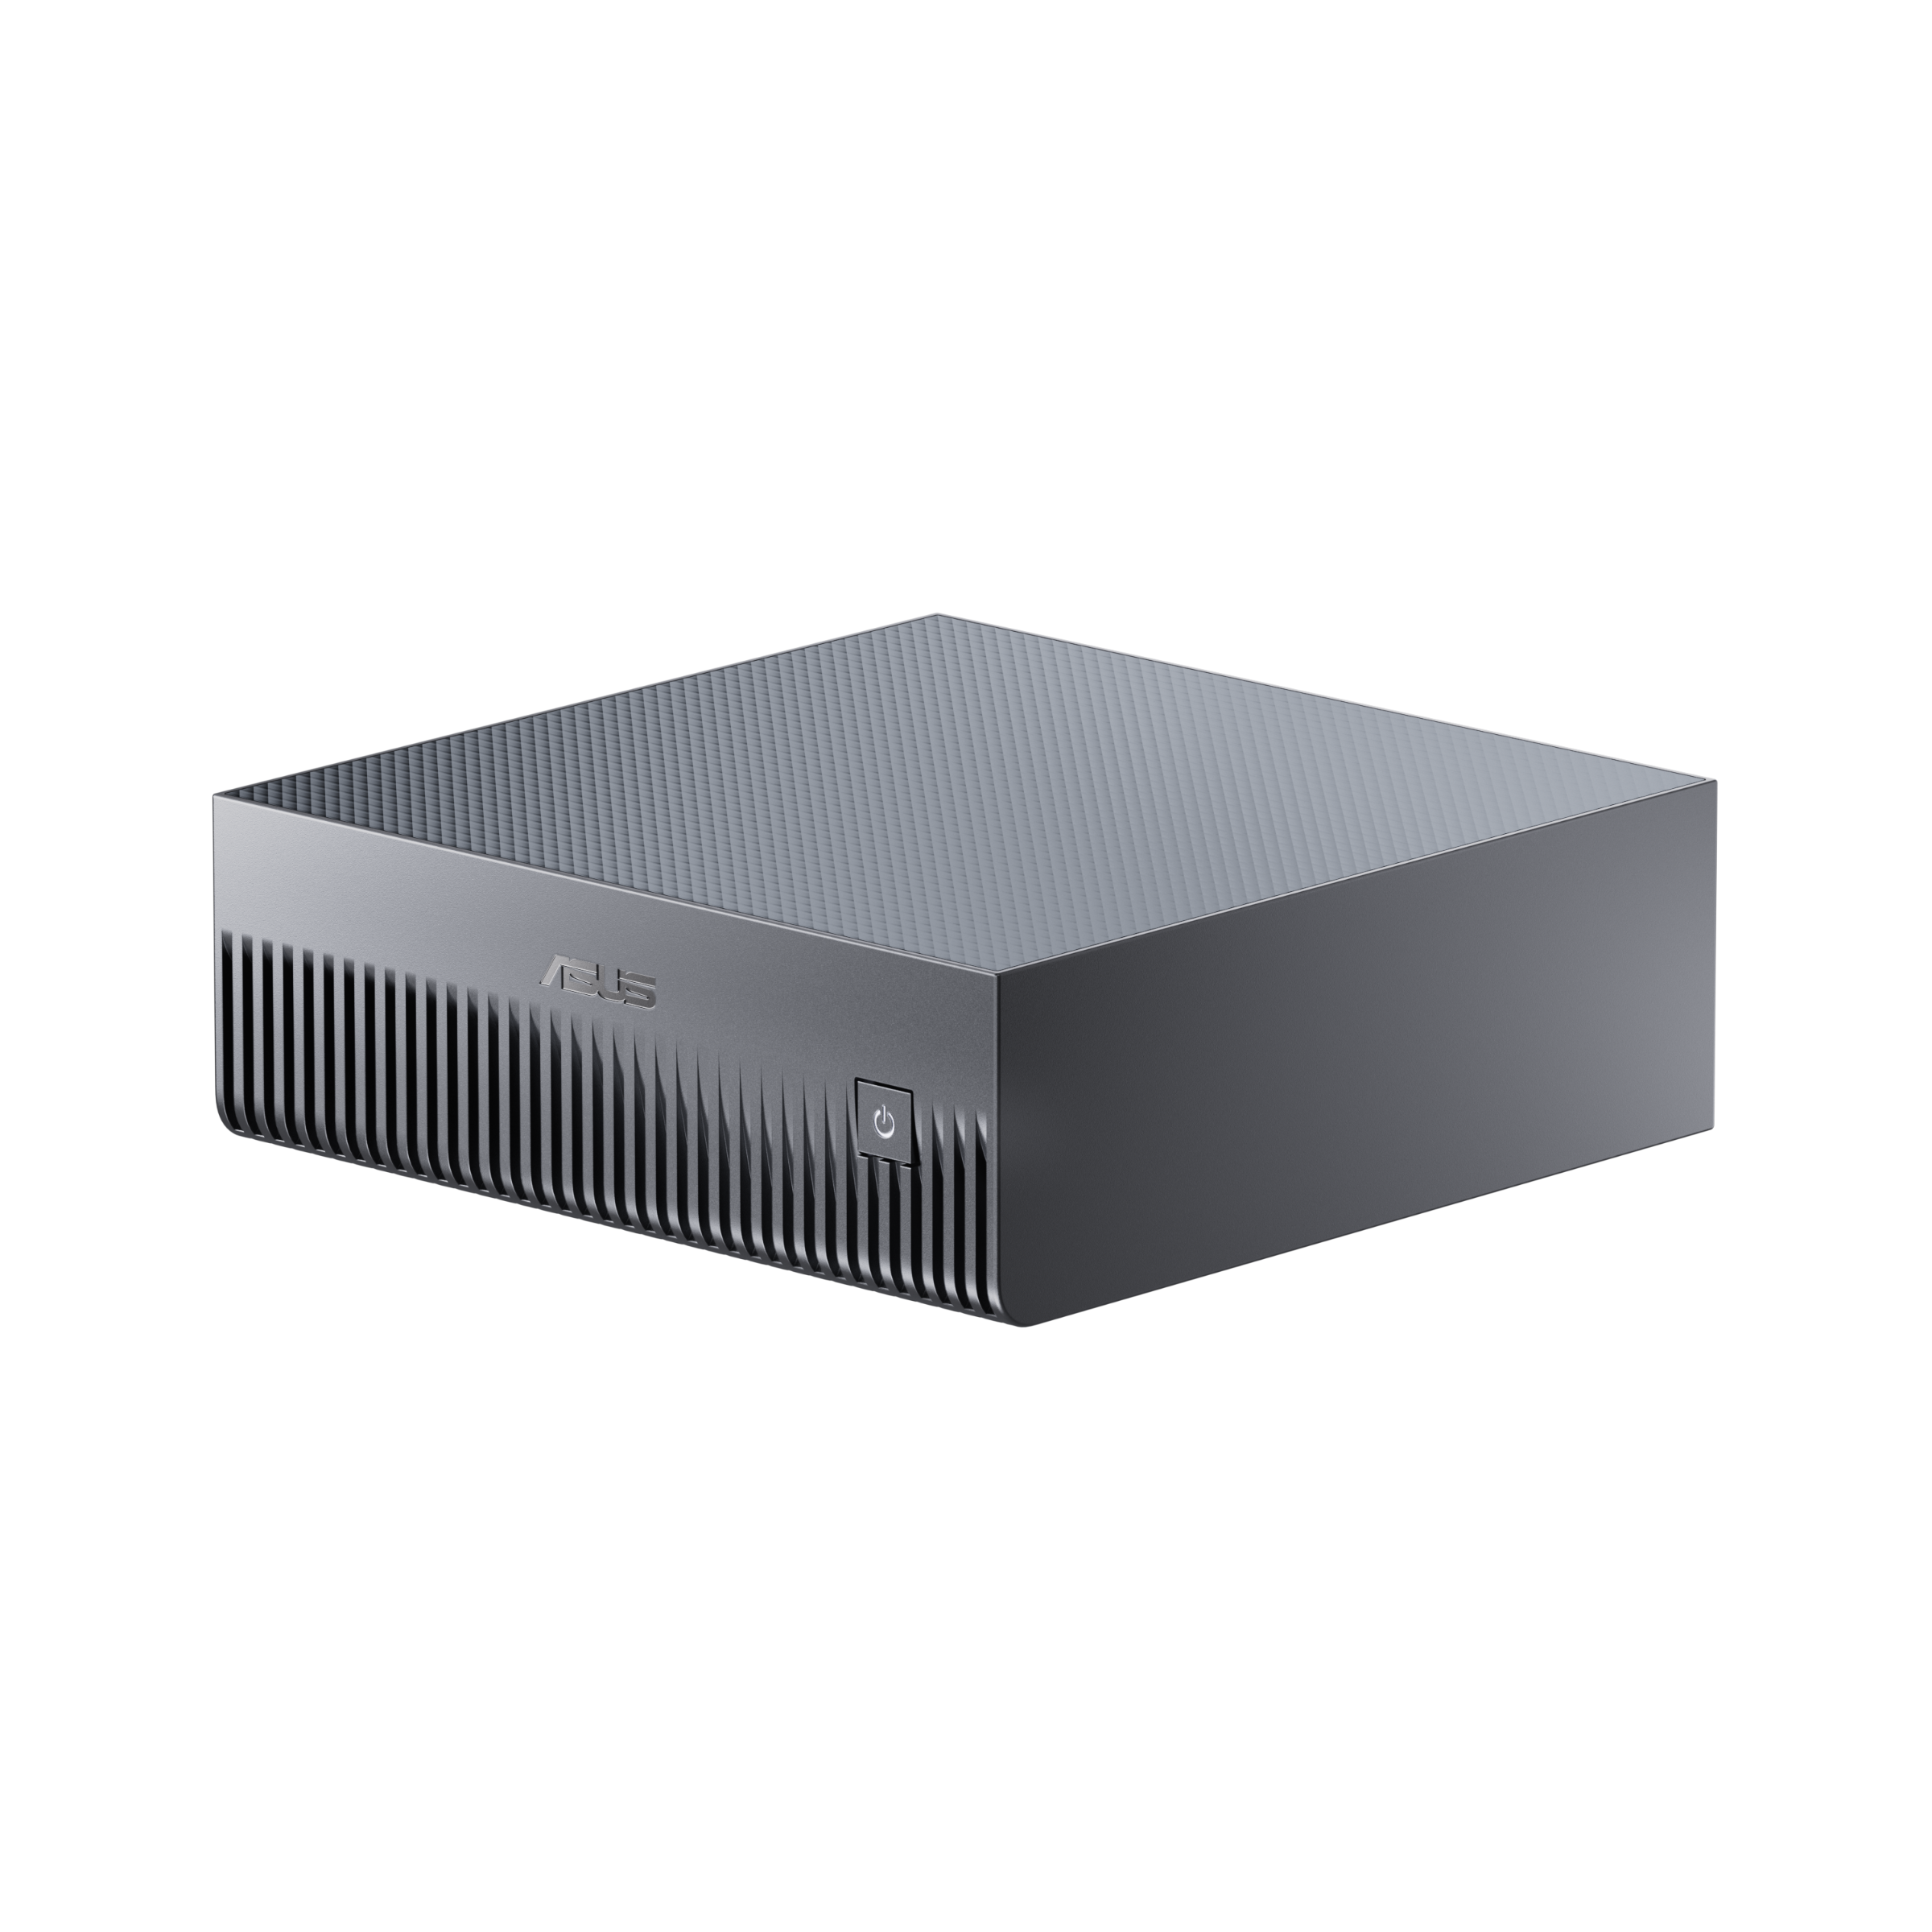
Укажите модель, код, наборы данных и число параллельных тестов. До начала подтвердим цену, доступность и способ подключения.
Нет гарантии точности. LLM может выдумать факты, не заметить смену рыночного режима или ошибиться в расчётах. Проверяйте выводы на данных и не используйте ответ модели как единственное основание для сделки.
Да, можно исследовать исторические данные и прототипировать аналитику по цифровым активам. Подключение к реальным счетам не требуется для исследовательского сценария.
Он позволяет запускать более крупные модели и обрабатывать большие наборы данных. Скорость зависит от модели, метода и кода.